Когда NPC должен сначала найти патроны, потом добежать до укрытия, затем перезарядиться и только после этого открыть огонь, ручная схема из десятков состояний быстро начинает ломаться. Добавление одного нового условия, например «если здоровье ниже 25%, искать аптечку», заставляет менять переходы почти во всех узлах. В результате поведение выглядит правдоподобно только до первого расширения проекта.
GOAP решает именно эту проблему. Агент перестаёт «переключаться между состояниями» и начинает искать последовательность действий, которая приводит к цели. У каждого действия есть предусловия и эффекты, а состояние мира описывается набором фактов. Если обстановка изменилась, план можно построить заново, не переписывая всю логику NPC. Для Unity это особенно удобно в проектах с большим числом типовых агентов: охранников, врагов, выживших, компаньонов, NPC в симуляциях и стратегиях.
Подход не отменяет других систем ИИ. Он хорошо сочетается с Behaviour Tree в Unity, Utility AI и даже с обычной FSM, если разделить задачи между уровнями. Но именно GOAP удобно использовать там, где важны гибкость, переиспользование действий и способность агента находить путь к цели в меняющейся среде.
Что такое GOAP и чем он отличается от FSM и деревьев поведения
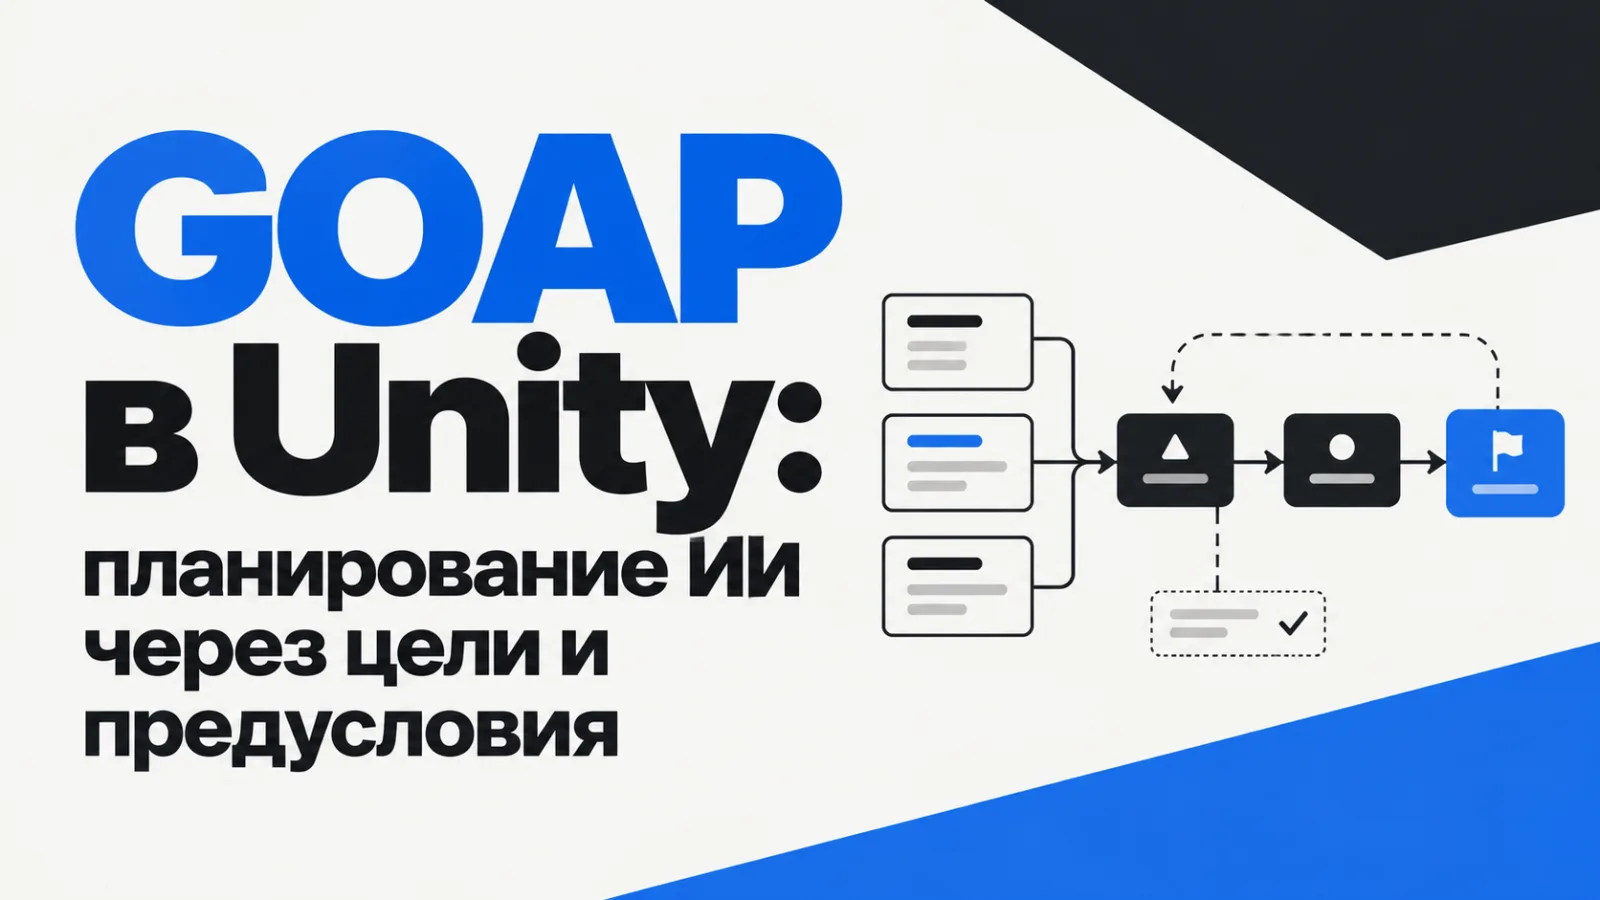
GOAP расшифровывается как Goal-Oriented Action Planning. Смысл подхода в том, что у агента есть цель, список доступных действий и описание мира в виде фактов. Система планирования не выбирает действие «по настроению», а строит план, который из текущего состояния приводит к нужному результату. Если коротко, цель задаёт направление, предусловия ограничивают применимость, эффекты меняют состояние мира.
На практике это меняет саму структуру кода. В конечном автомате переходы жёстко связаны друг с другом. В Behaviour Tree поведение описывается в виде дерева условий и последовательностей. В GOAP любое действие может использоваться в разных планах, если его предусловия подходят. Например, действие «взять оружие» может использоваться как часть плана «защититься», «напасть» или «проверить территорию», если мир уже содержит нужные факты.
Сильная сторона GOAP особенно заметна в проектах с большим количеством комбинаций. Если NPC должен уметь есть, спать, искать укрытие, атаковать, обследовать зону, открывать двери, перезаряжаться и лечить себя, количество переходов в FSM растёт быстрее, чем сам список действий. В GOAP расширение чаще сводится к добавлению нового действия и нескольких фактов. Старая логика не разрушается.
При этом GOAP не решает всё. Если нужна микротактика в бою, плавные анимационные переходы или строгая постановка сцены, один лишь планировщик не спасёт. На уровне исполнения плана часто всё равно нужны анимационные стейты, навигация, коллизии, таймеры и проверки на занятость. Поэтому GOAP лучше воспринимать как слой принятия решений, а не как единственный способ строить поведение.
Состояние мира как набор фактов
Основа GOAP - это описание мира в виде фактов, которые агент считает истинными на текущий момент. Такой факт обычно выражается парой «имя-значение» или просто булевым флагом. Например: HasWeapon = true, EnemyVisible = false, IsHungry = true, HasAmmo = false. В более сложных системах факты могут хранить числа, ссылки на объекты или категории целей, но начинать лучше с простого набора булевых признаков.
Ключевая идея состоит в том, что планировщик не смотрит на сцену напрямую каждый раз, когда выбирает действие. Вместо этого он работает с компактным снимком состояния. Это делает логику предсказуемой и тестируемой. Если факт «враг виден» равен false, агент не должен планировать атаку, пока не получит другое состояние. Если факт «дверь открыта» уже true, повторное открытие может не входить в план.
На уровне архитектуры удобно разделять мир на глобальные факты и локальные факты агента. Глобальные факты относятся к сцене или игровой системе: время суток, тревога на базе, состояние зоны. Локальные факты описывают самого NPC: здоровье, инвентарь, текущую цель, видимость врага. Такое разделение уменьшает связанность и помогает не таскать по каждому агенту лишние данные.
Пример структуры фактов в C#
Для простого проекта подойдёт класс состояния на словаре строк и булевых значений. Да, строковые ключи не идеальны для высоконагруженных систем, но для ясного первого прототипа они позволяют быстро увидеть механику GOAP. Позже их можно заменить на более строгие идентификаторы, enum или хеши.
using System.Collections.Generic;
using UnityEngine;

public sealed class WorldState
{
    private readonly Dictionary<string, bool> facts = new();

    public bool Get(string key)
    {
        return facts.TryGetValue(key, out var value) && value;
    }

    public void Set(string key, bool value)
    {
        facts[key] = value;
    }

    public WorldState Clone()
    {
        var copy = new WorldState();
        foreach (var pair in facts)
            copy.facts[pair.Key] = pair.Value;
        return copy;
    }

    public void ApplyEffects(IEnumerable<FactEffect> effects)
    {
        foreach (var effect in effects)
            Set(effect.Key, effect.Value);
    }
}

[System.Serializable]
public struct FactEffect
{
    public string Key;
    public bool Value;
}
Здесь состояние мира умеет хранить, читать, клонировать и изменять факты. Важный момент - метод Clone(). Планировщик будет пробовать действия в воображаемой копии мира, а не в реальном состоянии NPC. Если этого не сделать, поиск плана начнёт менять мир прямо во время расчёта и быстро сломает поведение.
Для небольших проектов такой словарь обычно достаточно удобен. Но если в игре много NPC и факты проверяются сотни тысяч раз за кадр, строки и словари начнут стоить дороже, чем выглядит на первый взгляд. В этом случае лучше использовать заранее определённые индексы, битовые маски или компактные структуры. Особенно это актуально на мобильных устройствах, где лишние аллокации и обращения к строкам быстрее отражаются на кадре, чем на ПК.
Действие в GOAP как контракт между предусловиями и эффектами
Каждое действие в GOAP описывается не в терминах анимации или конкретного метода, а в терминах условий применимости и результата. Если действие можно начать только при наличии оружия и видимости цели, это его предусловия. Если после выполнения оружие заряжено, а патроны уменьшились, это эффекты. Такой контракт делает действия переиспользуемыми и независимыми от того, кто именно их вызывает.
Планировщик работает с этим контрактом очень прямолинейно. Он берёт текущее состояние, проверяет, можно ли выполнить действие сейчас, затем симулирует его эффекты и смотрит, приближает ли это к цели. Когда действие завершено, реальные игровые системы синхронизируют фактическое состояние с планом. Поэтому важно не смешивать «логический эффект» и «визуальное действие». Например, факт EnemyInRange = true может быть истинным, даже если анимация ещё не закончилась, но только если боевое правило это допускает.
Базовый класс действия
using System.Collections.Generic;
using UnityEngine;

public abstract class GoapAction : ScriptableObject
{
    [SerializeField] private float cost = 1f;
    [SerializeField] private List<FactEffect> effects = new();

    public float Cost => cost;
    public IReadOnlyList<FactEffect> Effects => effects;

    public abstract bool ArePreconditionsMet(WorldState state);

    public virtual bool IsUsable(WorldState state)
    {
        return ArePreconditionsMet(state);
    }

    public void Apply(WorldState state)
    {
        state.ApplyEffects(effects);
    }
}
Использование ScriptableObject здесь удобно не случайно. Действия можно хранить как ассеты, настраивать в инспекторе, переиспользовать между разными NPC и не захламлять сцены множеством компонентов. Это хорошо сочетается с редакторскими инструментами Unity и снижает риск того, что логика расползётся по десяткам MonoBehaviour. Для проектов, где на сцене много однотипных врагов, такой подход экономит время на поддержке.
Однако ScriptableObject подходит не во всех случаях. Если действие содержит ссылку на конкретный объект сцены, активную анимацию, навигационный путь или временное состояние исполнения, одних ассетов недостаточно. Тогда нужен отдельный runtime-объект, который хранит состояние выполнения. Иначе при одновременном запуске одного и того же действия разными NPC начнут возникать конфликты данных.
Как строится план и почему поиск чаще всего идёт от цели к текущему состоянию
Самая распространённая схема GOAP использует поиск пути не в пространстве, а в пространстве состояний. Идея похожа на A*, только вместо клеток карты узлами являются состояния мира. Начальный узел - текущее состояние. Целевой узел - состояние, где все факты цели истинны. Рёбра между ними - действия, которые меняют состояние.
На практике планировщик проверяет все действия, выбирает те, чьи предусловия подходят текущему состоянию, применяет эффекты в копии мира и продолжает поиск. Чтобы план был не просто любым, а относительно дешёвым, действия получают стоимость. Самый дешёвый план не всегда самый «человеческий», но он обычно быстрее и проще для отладки. Позже стоимость можно комбинировать с эвристикой, чтобы предпочитать, например, более безопасные или более короткие последовательности.
Если реализовывать поиск с приоритетной очередью, можно добиться поведения, близкого к A*. Но для прототипа нередко достаточно и более простого обхода с ограничением глубины. Важно не перегружать первую версию. GOAP сложнее не алгоритмом, а количеством интеграционных деталей: как хранить факты, как кешировать планы, как прерывать выполнение, как перепланировать при изменении мира.
Простой планировщик на C#
using System.Collections.Generic;
using System.Linq;

public sealed class GoapPlanner
{
    private sealed class Node
    {
        public WorldState State;
        public List<GoapAction> Plan = new();
        public float Cost;
    }

    public List<GoapAction> BuildPlan(WorldState startState, WorldState goalState, List<GoapAction> actions, int maxDepth = 10)
    {
        var open = new Queue<Node>();
        open.Enqueue(new Node { State = startState.Clone(), Cost = 0f });

        while (open.Count > 0)
        {
            var current = open.Dequeue();

            if (IsGoalReached(current.State, goalState))
                return current.Plan;

            if (current.Plan.Count >= maxDepth)
                continue;

            foreach (var action in actions)
            {
                if (!action.IsUsable(current.State))
                    continue;

                var nextState = current.State.Clone();
                action.Apply(nextState);

                var nextPlan = new List<GoapAction>(current.Plan) { action };
                open.Enqueue(new Node
                {
                    State = nextState,
                    Plan = nextPlan,
                    Cost = current.Cost + action.Cost
                });
            }
        }

        return null;
    }

    private bool IsGoalReached(WorldState state, WorldState goalState)
    {
        // Цель считается достигнутой, если все факты цели совпадают.
        // Для простоты используем только булевы факты.
        return goalStateFacts.All(pair => state.Get(pair.Key) == pair.Value);
    }

    private readonly Dictionary<string, bool> goalStateFacts = new();
}
Этот код показывает механику, но в таком виде его нельзя считать полноценным решением. Здесь нет приоритизации, защиты от повторного посещения одинаковых состояний, учёта стоимости пути и нормальной структуры цели. Тем не менее он полезен как первая рабочая схема: можно увидеть, как действия цепляются друг за друга и как итоговый план появляется без ручных переходов.
На следующем шаге обычно добавляют сравнение состояний и кеш закрытых узлов. Без этого поиск быстро начинает ходить по кругу, особенно если в наборе действий есть операции с обратными эффектами, например «взять оружие» и «положить оружие». Для реального проекта нужно хранить уже посещённые комбинации фактов и не расширять их повторно.
Цели в GOAP и выбор между несколькими вариантами поведения
Цель в GOAP описывает не действие, а желаемое состояние мира. Для NPC это может быть EnemyDead = true, HasFood = true, IsSafe = true, HasAmmo = true. Сама по себе цель не говорит, как к ней идти. Этот выбор оставляет планировщику. Именно поэтому одна и та же цель может достигаться по-разному, если доступные действия различаются по стоимости или по текущему контексту.
В сложных системах у агента бывает не одна цель, а несколько конкурирующих. Охранник может одновременно хотеть оставаться на посту, реагировать на тревогу и восстанавливать здоровье. Тогда требуется слой выбора цели. Здесь GOAP часто соединяют с Utility AI: один механизм решает, какая цель сейчас приоритетна, другой строит план достижения этой цели. Такое разделение довольно устойчиво, особенно когда поведение нужно делать расширяемым без переписывания планировщика.
Если проект уже использует систему квестов, цели GOAP удобно оформлять в том же стиле: как факты с прогрессом и условиями завершения. Тогда и квестовая логика, и ИИ начинают говорить на одном языке. Это снижает число специальных случаев, когда одно подсистемное правило противоречит другому.
Пример описания цели
using System.Collections.Generic;
using UnityEngine;

[CreateAssetMenu(menuName = "GOAP/Goal")]
public class GoapGoal : ScriptableObject
{
    [SerializeField] private List<FactEffect> desiredFacts = new();
    [SerializeField] private float priority = 1f;

    public float Priority => priority;
    public IReadOnlyList<FactEffect> DesiredFacts => desiredFacts;

    public bool IsSatisfiedBy(WorldState state)
    {
        foreach (var fact in desiredFacts)
        {
            if (state.Get(fact.Key) != fact.Value)
                return false;
        }
        return true;
    }
}
Такая структура помогает отделить описание цели от конкретного NPC. Один и тот же ассет можно использовать для разных агентов, если смысл цели одинаковый. Например, «быть в безопасности» может означать разное для выжившего и для охранника, но формально их цель всё равно сводится к набору фактов. Если же смысл отличается слишком сильно, лучше не пытаться свести всё в один объект, а сделать две отдельные цели.
Перепланирование при изменении мира
План в GOAP не должен считаться «раз и навсегда». Мир меняется, и именно в этом заключается его практическая ценность. Дверь закрылась, враг переместился, предмет пропал, союзник занял укрытие, патроны закончились. Если агент продолжит следовать старому плану вслепую, поведение станет не только неэффективным, но и нелепым. Поэтому перепланирование - обязательная часть системы, а не дополнение на потом.
Существует несколько типичных триггеров для перепланирования. Самый очевидный - текущий план стал невыполнимым: факт, который был истинным при построении, изменился. Второй случай - появился более приоритетный план. Например, NPC шёл за аптечкой, но заметил врага и должен срочно перейти к укрытию. Третий случай - текущее действие завершилось неудачей: путь заблокирован, объект исчез, цель ушла из зоны видимости. Во всех этих ситуациях агент должен пересчитать решение.
Если перепланирование происходит слишком часто, поведение становится дёрганым. Агент может начинать новое действие, почти сразу отменять его и снова искать альтернативу. Чтобы этого избежать, обычно вводят стабилизацию: минимальное время удержания плана, порог значимости изменения, проверку доступности только ключевых фактов. Особенно это полезно для мобильных игр и проектов, где десятки NPC одновременно реагируют на изменения сцены.
Проверка актуальности плана
using System.Collections.Generic;

public sealed class GoapAgentMemory
{
    public List<GoapAction> CurrentPlan { get; private set; }
    public int CurrentActionIndex { get; private set; }

    public void SetPlan(List<GoapAction> plan)
    {
        CurrentPlan = plan;
        CurrentActionIndex = 0;
    }

    public void Advance()
    {
        if (CurrentPlan == null)
            return;

        CurrentActionIndex++;
    }

    public bool IsPlanValid(WorldState currentWorld)
    {
        if (CurrentPlan == null || CurrentActionIndex >= CurrentPlan.Count)
            return false;

        var nextAction = CurrentPlan[CurrentActionIndex];
        return nextAction.IsUsable(currentWorld);
    }
}
Такой код показывает только базовую проверку. На практике план часто валиден не до конца: первое действие возможно, а второе уже нет. Тогда система может либо дойти до конца текущего шага и перепланировать после него, либо пересчитать план заранее, если нарушение критично. Выбор зависит от жанра и требований к отзывчивости. В шутере перепланирование обычно должно быть быстрым и незаметным, а в пошаговой игре допускается больше задержек.
Интеграция с Unity, NavMesh и анимациями
GOAP отвечает за решение «что делать», но не за физическое исполнение. В Unity это почти всегда означает связку с NavMeshAgent, анимационным деревом и компонентами взаимодействия. Планировщик говорит NPC, что нужно добежать до укрытия, а уже NavMeshAgent строит маршрут и двигает персонажа по сцене. Анимация при этом может переключаться отдельно, через параметры Animator или через собственный слой состояния.
Практически удобная схема выглядит так: GOAP выдаёт текущую задачу, исполнитель действия проверяет реальную достижимость, запускает навигацию, ждёт завершения и сообщает о результате. Если путь не найден, действие возвращает неудачу, после чего планировщик либо ищет альтернативу, либо отбрасывает текущий план. В таких случаях полезно помнить о связке с навигацией и использовать уже знакомые приёмы из CharacterController или других систем движения, если NavMesh не подходит под жанр.
Частая ошибка - напрямую запускать движение из планировщика. Тогда код быстро смешивает уровни ответственности, и при любом сбое становится непонятно, где сломался маршрут: в логике планирования, в навигации, в анимации или в коллизиях. Разделение на «решение», «исполнение» и «наблюдение результата» делает систему гораздо устойчивее, а отладка в Unity Editor становится ощутимо проще.
Пример исполнительного действия для движения
using System.Collections;
using UnityEngine;
using UnityEngine.AI;

[CreateAssetMenu(menuName = "GOAP/Actions/Move To Target")]
public class MoveToTargetAction : GoapAction
{
    [SerializeField] private string targetVisibleFact = "TargetVisible";
    [SerializeField] private string reachedTargetFact = "ReachedTarget";

    public override bool ArePreconditionsMet(WorldState state)
    {
        return state.Get(targetVisibleFact);
    }

    public IEnumerator Execute(NavMeshAgent agent, Transform target, WorldState world)
    {
        agent.SetDestination(target.position);

        while (agent.pathPending)
            yield return null;

        while (agent.remainingDistance > agent.stoppingDistance)
            yield return null;

        world.Set(reachedTargetFact, true);
    }
}
Этот пример показывает важную практическую мысль: планировщик может быть полностью отделён от рантайм-исполнения. Состояние мира обновляется после фактического завершения действия, а не в момент расчёта плана. Это убирает многие гонки и нестыковки. Если хочется сделать поведение ближе к производственному уровню, полезно добавить тайм-ауты, отмену и проверку того, что цель действительно ещё существует.
Если в проекте используются готовые наборы персонажей, оружия и окружения, например Assault Character Pack Remastered, Firearms - Low Poly 3D Models Pack или Low Poly Ultimate Pack, GOAP особенно полезен для быстрой сборки разных типов NPC без переписывания логики под каждый визуальный набор.
Оптимизация поиска и ограничения подхода
GOAP часто критикуют за вычислительную стоимость. И критика справедлива, если пытаться делать всё без ограничений. Пространство состояний растёт быстро. Если фактов слишком много, а действий многоуровневые, полный перебор начинает стоить заметных миллисекунд даже на сильном CPU. Для 100 NPC с отдельным поиском плана уже легко выйти на лишние 3-8 мс на кадр, если не ограничивать глубину, не кешировать результаты и не снижать частоту пересчёта.
Поэтому в реальном проекте используют несколько практических ограничений. План не пересчитывают каждый кадр, если для этого нет причины. Часть NPC может обновлять план раз в 0.25-1 секунду, а не на каждом Update(). Для второстепенных агентов и вовсе допустима ступенчатая логика: один кадр проверяется один NPC, следующий кадр другой. Это хорошо сочетается со статьёй про свой Update Manager.
Ещё один источник проблем - слишком крупные или слишком мелкие факты. Если факт описывает «NPC доволен жизнью», планировщик почти ничего не понимает о реальных шагах. Если же фактов слишком много и каждый отражает мелкую анимационную деталь, состояние становится хрупким и плохо читаемым. Нужен баланс: факты должны быть достаточно абстрактными, чтобы их можно было использовать в нескольких действиях, и достаточно конкретными, чтобы по ним можно было строить осмысленный план.
GOAP хорошо работает там, где поведение можно описать через повторяемые действия и чёткие условия. Если решение зависит от непрерывных чисел, вероятностей, анимационных окон и множества тактических нюансов, одного планировщика обычно недостаточно.
Частые ошибки при внедрении GOAP в Unity
Самая распространённая ошибка - попытка моделировать в GOAP вообще всё поведение NPC. В результате в планировщик попадают не только боевые и бытовые действия, но и нюансы анимации, звуков, камеры, камеры отладки и даже UI. Это перегружает систему и делает её неуправляемой. Лучше сразу определить, что GOAP отвечает за высокоуровневые решения, а исполнительные детали остаются в отдельных подсистемах.
Вторая ошибка - хранить слишком мало информации о причине неудачи. Если действие не выполнилось, полезно знать, почему именно: путь недоступен, враг исчез, предмет уже занят, анимация сорвалась, таймер истёк. Без этой информации отладка превращается в угадывание. Для этого в коде стоит возвращать не просто true или false, а результат с кодом ошибки или хотя бы логируемой причиной.
Третья типичная проблема - отсутствие тестов на планирование. GOAP довольно хорошо поддаётся модульной проверке, потому что план можно строить на чистом состоянии без сцены. Для таких систем полезны Unit-тесты в Unity. Можно проверять, что из набора фактов и действий всегда находится ожидаемый план, а при изменении мира система корректно отказывается от невалидной последовательности.
Как уменьшить риск ошибок на старте
- Сначала реализуйте 3-5 действий и одну цель, которую можно проверить без анимаций и NavMesh.
- Проверьте, что план строится на чистом состоянии и не меняет реальный мир до исполнения.
- Добавьте логирование плана в Console и убедитесь, что каждый шаг объясним по фактам.
- Только после этого подключайте движение, анимацию и смену целей.
Такой порядок разработки кажется медленнее, но он экономит часы на поиске ошибок. Если сразу начать с боевого NPC, стреляющего, прячущегося и перезаряжающегося, непонятно, сломалась ли логика поиска, фактические предусловия или исполнительный слой. Минимальный набор сценариев даёт прозрачную базу для расширения.
Когда GOAP подходит лучше других подходов
GOAP особенно полезен там, где поведение должно собираться из одинаковых блоков и реагировать на контекст без ручного кодирования всех переходов. В survival-играх это сбор ресурсов, поиск еды, лечение, побег от угроз. В шутерах это укрытие, перезарядка, поиск цели, смена позиции. В симуляциях и стратегиях это обслуживание объектов, перемещение, производство, ремонт, исследование территории. В таких жанрах хорошо смотрятся готовые сцены и шаблоны вроде (STP) Survival Template PRO или Survival Island | Template + Editor, если требуется быстро собрать прототип и проверить, как ИИ вписывается в игру.
Если же поведение почти статично, а количество состояний невелико, GOAP может быть избыточным. Для одного босса с пятью фазами или для простого моба с патрулём и атакой часто выгоднее FSM или компактное дерево поведения. Там, где действия не комбинируются, а просто включаются по этапам, планировщик добавит лишнюю сложность без заметной пользы. То есть решение зависит не от «модности» подхода, а от числа комбинаций и темпа изменений.
Хороший практический критерий такой: если при добавлении нового поведения приходится пересматривать много старых переходов, GOAP уже уместен. Если же новое действие логично встраивается в одну-две ветки, а вся система остаётся читаемой, переход на планирование пока не нужен. Это экономит время команды и не превращает архитектуру в преждевременно усложнённую конструкцию.
Практический шаблон внедрения GOAP в Unity
Надёжнее всего внедрять GOAP поэтапно. Сначала создаётся слой фактов, затем набор действий, после этого простой планировщик и только потом исполнитель. В инспекторе можно хранить ассеты целей и действий, а в runtime-компоненте - ссылку на текущее состояние мира, текущую цель и активный план. Для расширения удобно использовать либо ScriptableObject-ассеты, либо отдельные классы конфигурации, если нужно загружать поведение из JSON или другого источника данных.
При этом имеет смысл сразу ввести отладочный вывод. Для каждого NPC полезно видеть текущую цель, список фактов и актуальный план. Даже обычный текст в окне Scene или над головой агента часто экономит больше времени, чем сложные графические отладчики. Если игра крупная, можно сделать редакторское окно через EditorWindow и MenuItem в Unity и просматривать планы всех агентов в реальном времени.
Ещё один полезный приём - ограничивать число действий, доступных на конкретной сцене или типу NPC. Не нужно выдавать охраннику действия фермера, а торговцу - боевые манёвры, если это не предусмотрено дизайном. Чем меньше нерелевантных действий, тем быстрее строится план и тем проще отладка. Это особенно заметно на слабых устройствах и в больших уровнях, где любое лишнее расширение поиска создаёт шум.
Для визуального и звукового наполнения планов полезно подбирать ассеты, которые не требуют сложной ручной синхронизации. Например, для тактического шутера удобно сочетать логику GOAP с наборами окружения и персонажей вроде Modular Multiplayer FPS Engine (Photon 2) или MultiFPS - Multiplayer FPS, а для стилизованных сцен подойдут Stylized Nature Bundle и Poly Universal Pack.
Что сделать дальше
Если в проекте уже есть набор повторяющихся NPC и ручная логика начала разрастаться, имеет смысл выделить 5-7 базовых фактов, описать 3-5 действий и собрать один прототип GOAP-агента без визуальных деталей. После этого нужно проверить, как быстро строится план, при каких изменениях он ломается и насколько понятно читается результат в отладке. Только затем стоит подключать NavMesh, анимации и более сложные цели.
Для следующего шага полезно одновременно держать под рукой материал по поведению, движению и структуре данных: GOAP лучше всего раскрывается не сам по себе, а в связке с навигацией, тестами и редакторскими инструментами. Когда каркас будет стабилен, добавление новых NPC начнёт требовать новых фактов и действий, а не переписывания старых переходов.